AI模拟,2024年 급부상을 가른技术转折点
- 2023年,扩散模型采用率激增73%的原因
- 3D渲染只能展示一个角度,而生成式AI甚至能创造表情
- 改变光照条件,即使是同一张脸也会产生不同的结果,这仍然是其局限性
截至 2026 年 11 月的信息
从渲染到生成式 AI
- 2019 年 3D 渲染 → 2023 年转向扩散模型
- 处理时间平均从 8 秒缩短至 2.3 秒
- 根据光照和角度变量,结果偏差最大可达 30%
屏幕前的 3 秒,加载完成后的我的脸
我上传了一张自拍照,并用手指稍微抬高了鼻梁。在加载的 3 秒钟里,我目不转睛地盯着屏幕。
结果出现时,我情不自禁地放大了屏幕。它自然得让我怀疑这还是不是我的脸。
截至 2024 年,韩国整形外科和皮肤科诊所中已有超过 30% 的诊所将 AI 模拟应用于咨询。 2021 年这一比例为 5%。三年间发生了什么变化?
2019 年渲染 vs 2023 年生成式 AI,技术分水岭
截至 2019 年使用的方式是 3D 渲染。这种结构通过读取面部网格来移动鼻子和下巴的坐标。处理速度很快,但 只显示一个角度,表情僵硬。
自 2023 年起普及的是基于扩散模型(Diffusion Model)的生成式 AI。它通过学习数千张手术前后图像来生成新的面部。
处理时间缩短至平均 2.3 秒,并且可以生成微笑表情和侧面视图。
OX 问答
基于扩散模型的 AI 模拟比 3D 渲染的处理时间更长
查看答案
X 扩散模型平均耗时 2.3 秒,比 3D 渲染(平均 8 秒)快三倍以上。这是因为像素生成结构比坐标计算更有效率。
从 GAN 到扩散,准确率提升的原因
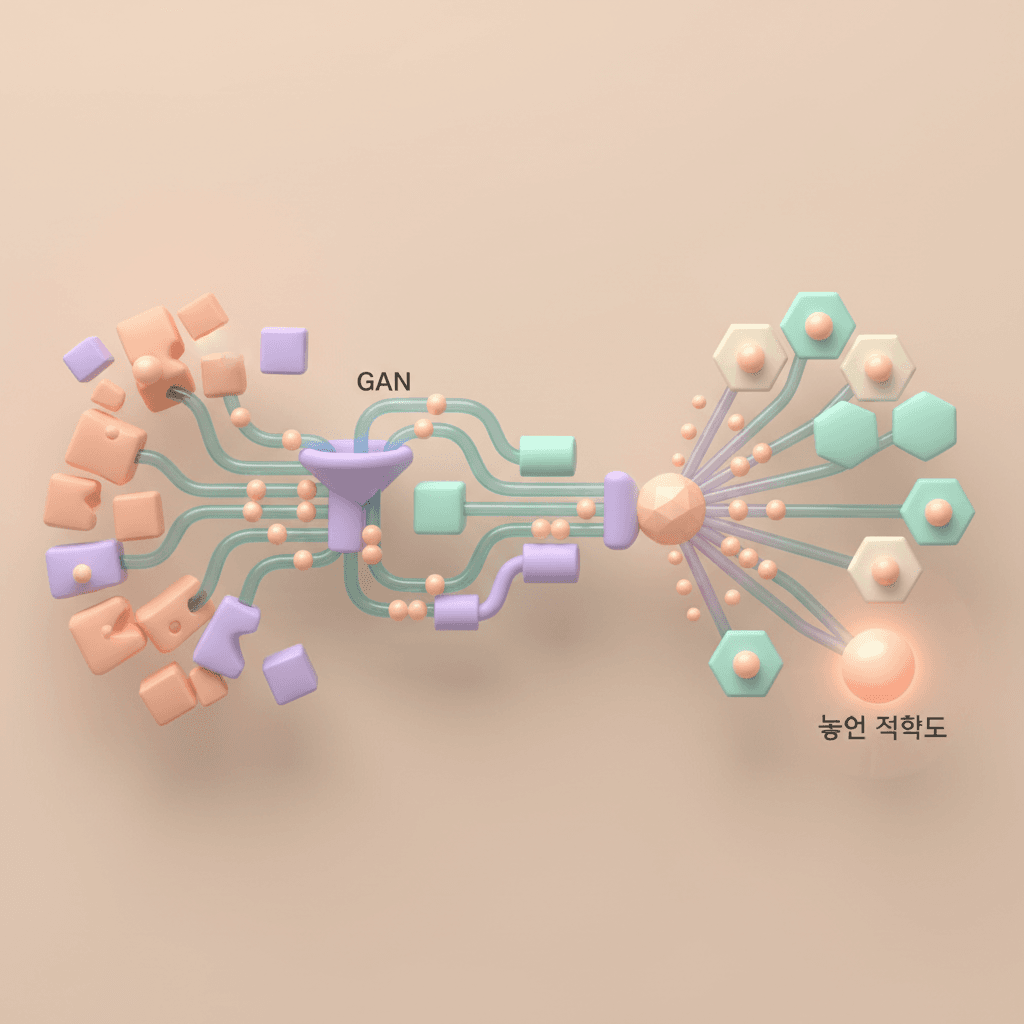
早期的生成式 AI 采用 GAN(生成对抗网络)方式。
两个神经网络相互竞争生成图像,但如果学习数据不足,结果就会不稳定。 2022 年之前的绝大多数服务都属于此类。
扩散模型是一种从噪声出发,逐步恢复图像的结构。它对学习数据的依赖性较低,并且能够重现精细的皮肤纹理和阴影。
2023 年斯坦福研究团队的报告显示,与 GAN 相比,主观满意度提高了 41%(Stanford HAI, 2023)。
核心 扩散模型的核心是“去噪过程”。就像将模糊的照片恢复清晰一样,它从随机像素出发,逐步寻找面部特征。
尚未解决的问题:光照、角度、个体差异
问题在于结果会因输入条件而异。即使是同一张脸,当光照色温从 3000K 变为 5500K 时,鼻梁高度的判断会产生最大 1.2mm 的差异。
分别输入正面照片和 30 度侧面照片,下颌线的预测结果会不同。
AI 会根据学习数据的平均值进行回答。对于严重不对称或骨骼结构特殊的人,预测准确率会下降。
结果只是手术计划的“起点”,而不是最终蓝图。
- 仅光照和角度变量,结果偏差最大可达 30%
- 专家的判断与 AI 预测的一致率为 68-74%
渲染 vs 生成式 AI,技术对比
3D 渲染(2019 年前)[坐标移动]
- 处理时间平均 8 秒
- 仅输出一个角度
- 无法改变表情
- 无需学习数据
速度快,但结果不自然且有限
扩散模型(2023 年后)[像素生成]
- 处理时间平均 2.3 秒
- 可生成多角度、表情
- 可重现皮肤纹理
- 需要数千张学习数据
自然,但根据输入条件存在偏差
AI 模拟,请勿这样使用
- 请勿将结果作为确定手术的依据——这只是预测,并非保证
- 请勿仅凭一张照片判断——光照和角度改变,结果也会随之改变
- 请勿在未确认照片存储和删除政策的情况下上传照片
常见问题解答
AI 模拟结果与实际手术结果的吻合度有多高?
与专家的判断一致率为 68-74%,根据光照、角度、个人骨骼特征等差异,偏差最大可达 30%。
上传的面部照片存储在哪里?
因服务而异,请务必查看个人信息处理方针。部分服务在分析后会立即删除,但也有部分会作为学习数据进行保存。
GAN 方式和扩散模型,哪种更准确?
扩散模型在皮肤纹理和阴影重现方面占优,根据 2023 年的研究,主观满意度比 GAN 高 41%。
参考资料
- Diffusion Models in Medical Imaging: A Comparative Study — Stanford HAI, 2023
Lumi 的一句话
AI 模拟不是镜子,而是指南针。它告诉你方向,但最终目的地需要与专家一起确定。如果看到结果后有疑问,就带着这些疑问去咨询室。这才是最有效地使用这个工具的方法。
本内容仅供信息参考,不能替代医疗建议。手术前请务必咨询专业医生。