ИИ-симуляция: технологический поворотный момент, определивший стремительный взлет в 2024 году
- Почему внедрение диффузионных моделей выросло на 73% за 2023 год
- 3D-рендеринг показывал только один угол, а генеративный ИИ создает даже мимику
- Пока что ограничением является то, что при изменении условий освещения одно и то же лицо дает разные результаты
Информация по состоянию на ноябрь 2026 г.
От рендеринга к генеративному ИИ
- Переход от 3D-рендеринга (2019 г.) к диффузионным моделям (2023 г.)
- Среднее время обработки сокращено с 8 секунд до 2,3 секунды
- Максимальное отклонение результата в зависимости от освещения и угла — до 30%
3 секунды перед экраном, мое лицо после загрузки
Я загрузил селфи и немного приподнял кончик носа пальцем. В течение 3 секунд, пока шла загрузка, я не отрываясь смотрел на экран.
Когда появился результат, я сам того не осознавая увеличил изображение. Оно было настолько естественным, что я подумал: «Это точно мое лицо?»
По состоянию на 2024 год более 30% корейских клиник пластической хирургии и дерматологии внедрили ИИ-симуляцию в консультации. В 2021 году этот показатель составлял 5%. Что же изменилось за 3 года?
Рендеринг 2019 г. против генеративного ИИ 2023 г.: технологический перекресток
До 2019 года использовался метод 3D-рендеринга. Он считывал лицо в виде сетки и перемещал координаты носа и подбородка. Обработка была быстрой, но отображался только один угол, а мимика была застывшей.
С 2023 года распространился генеративный ИИ на основе диффузионных моделей (Diffusion Model). Он обучается на тысячах изображений до и после процедур и создает новые лица.
Время обработки сократилось в среднем до 2,3 секунды, и теперь он может создавать улыбающиеся лица и профили.
Викторина О/Х
ИИ-симуляция на основе диффузионных моделей требует больше времени на обработку, чем 3D-рендеринг
Проверить ответ
X Диффузионные модели обрабатывают в среднем 2,3 секунды, что более чем в 3 раза быстрее, чем 3D-рендеринг (в среднем 8 секунд). Это связано с тем, что структура генерации пикселей эффективнее расчета координат.
От GAN к диффузии: причина повышения точности
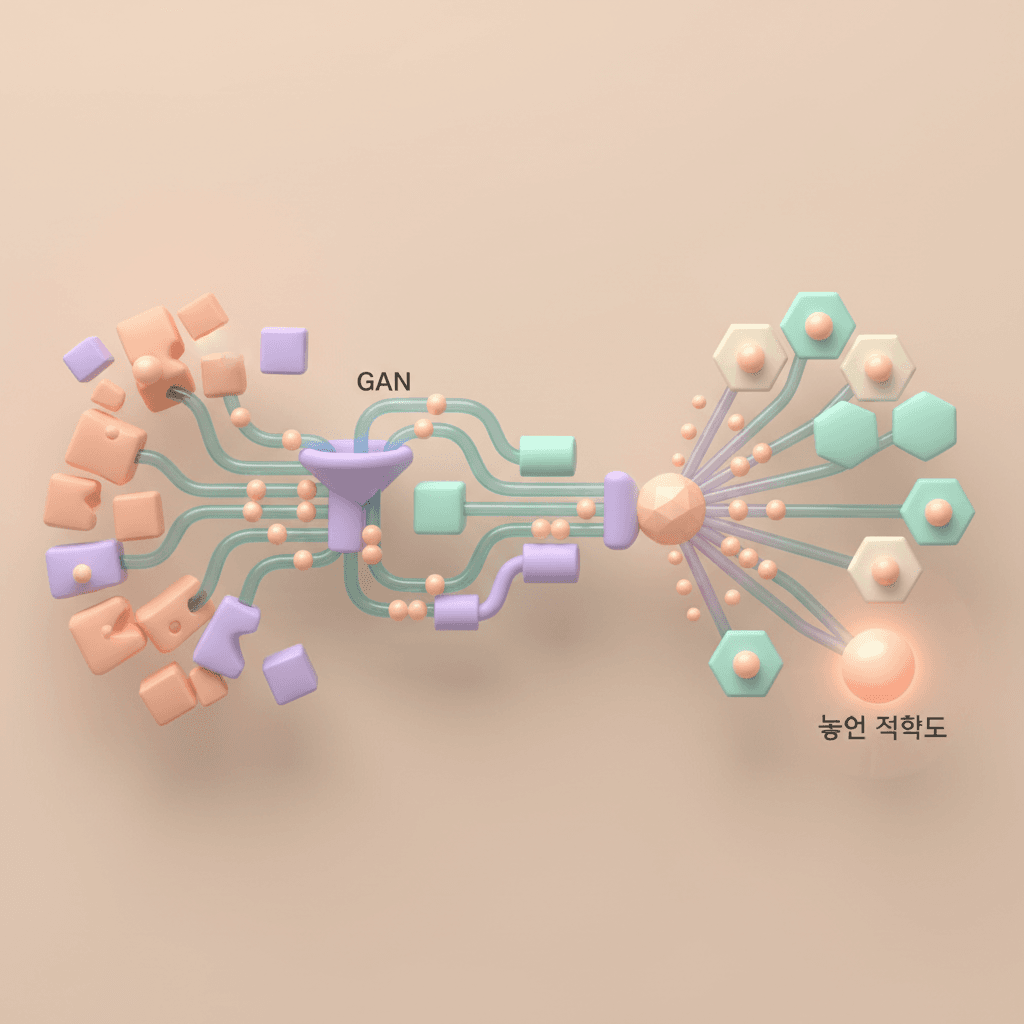
Ранний генеративный ИИ использовал метод GAN (Generative Adversarial Network).
Две нейронные сети конкурировали, создавая изображения, но при недостаточном количестве обучающих данных результат был нестабильным. Большинство сервисов до 2022 года относились к этой категории.
Диффузионная модель имеет структуру, которая постепенно восстанавливает изображение, начиная с шума. Она менее зависима от обучающих данных и воспроизводит даже мельчайшие детали текстуры кожи и тени.
В отчете исследовательской группы Стэнфордского университета за 2023 год субъективная удовлетворенность по сравнению с GAN была на 41% выше (Stanford HAI, 2023).
Ключевой момент «Процесс удаления шума» является основой диффузионных моделей. Подобно тому, как размытая фотография восстанавливается до четкости, они начинают со случайных пикселей и поэтапно определяют черты лица.
Что еще не решено: освещение, угол, индивидуальные особенности
Проблема в том, что результат варьируется в зависимости от входных условий. Даже у одного и того же лица при изменении цветовой температуры освещения с 3000K до 5500K разница в определении высоты носа может достигать 1,2 мм.
Если ввести поочередно фронтальное и боковое фото под углом 30 градусов, прогноз линии подбородка будет разным.
ИИ дает ответ, близкий к среднему значению обучающих данных. Точность прогноза снижается при выраженной асимметрии или уникальной структуре костей.
Результат — это «отправная точка» для планирования процедуры, а не окончательный чертеж.
- Максимальное отклонение результата только из-за вариаций освещения и угла — до 30%
- Совпадение между оценкой специалиста и прогнозом ИИ составляет 68-74%
Рендеринг против генеративного ИИ: сравнение технологий
3D-рендеринг (до 2019 г.) [Перемещение координат]
- Среднее время обработки 8 секунд
- Вывод только одного угла
- Невозможность изменения мимики
- Обучающие данные не требуются
Быстро, но результат неестественный и ограниченный
Диффузионная модель (после 2023 г.) [Генерация пикселей]
- Среднее время обработки 2,3 секунды
- Возможность создания разных ракурсов и мимики
- Воспроизведение текстуры кожи
- Требуется тысячи обучающих данных
Естественно, но возможны отклонения в зависимости от входных условий
ИИ-симуляция: как не следует ее использовать
- Не используйте результат как основание для подтверждения процедуры — это лишь прогноз, а не гарантия
- Не принимайте решение на основе одной фотографии — результат меняется при изменении освещения и угла
- Не загружайте фотографии, не проверив политику хранения и удаления изображений вашего лица
Часто задаваемые вопросы
Насколько результат ИИ-симуляции совпадает с реальным результатом процедуры?
Совпадение с оценкой специалиста составляет 68-74%, а отклонение может достигать 30% в зависимости от освещения, угла и индивидуальных особенностей скелета.
Где сохраняются загруженные фотографии моего лица?
Это зависит от сервиса, поэтому обязательно ознакомьтесь с политикой конфиденциальности. Некоторые сервисы удаляют фото сразу после анализа, но есть и те, кто хранит их в качестве обучающих данных.
Какой метод точнее: GAN или диффузионная модель?
Диффузионная модель превосходит GAN в воспроизведении текстуры кожи и теней, а по данным исследования 2023 года, субъективная удовлетворенность была на 41% выше, чем у GAN.
Источники
- Diffusion Models in Medical Imaging: A Comparative Study — Stanford HAI, 2023
Слово от Lumi
ИИ-симуляция — это не зеркало, а компас. Она указывает направление, но конечный пункт назначения определяется вместе со специалистом. Если у вас возникли вопросы после получения результата, возьмите их с собой на консультацию. Это лучший способ использовать этот инструмент.
Данный контент предназначен для информационных целей и не заменяет медицинскую консультацию. Перед проведением процедуры обязательно проконсультируйтесь со специалистом.