AI 模擬,2024 年 급부상을 가른 기술轉捩點
- 2023年,擴散模型導入率為何激增73%
- 3D渲染僅展示單一角度,生成式AI卻能創造表情
- 照明條件改變,即使是同一張臉也會產生不同結果,這仍是其侷限
截至 2026 年 11 月的資訊
從渲染到生成式 AI
- 2019 年 3D 渲染 → 2023 年轉換為擴散模型
- 處理時間平均從 8 秒縮短至 2.3 秒
- 根據照明和角度變數,結果差異高達 30%
螢幕前的 3 秒,載入完成後看到的我的臉
我上傳了一張自拍照,並用手指稍微墊高了鼻子的角度。在載入的 3 秒鐘裡,我目不轉睛地盯著螢幕。
結果出現時,我不自覺地放大了畫面。我幾乎不敢相信那是我的臉,因為它看起來太自然了。
截至 2024 年,國內超過 30% 的整形外科和皮膚科診所已將 AI 模擬導入諮詢服務。2021 年時,這個比例僅為 5%。在短短三年內,究竟發生了什麼變化?
2019 年渲染 vs 2023 年生成式 AI,技術的十字路口
截至 2019 年使用的技術是 3D 渲染。這種方法透過網格讀取臉部,然後移動鼻子和下巴的座標。處理速度很快,但只能顯示單一角度,表情也顯得僵硬。
自 2023 年起普及的是基於擴散模型 (Diffusion Model) 的生成式 AI。它透過學習數千張手術前後的圖像來生成新的臉部。
處理時間縮短至平均 2.3 秒,並且能夠生成微笑表情和側面視圖。
OX 測驗
基於擴散模型的 AI 模擬比 3D 渲染需要更長的處理時間
確認答案
X 擴散模型平均需要 2.3 秒,比 3D 渲染(平均 8 秒)快三倍以上。這是因為像素生成結構比座標計算更有效率。
從 GAN 到擴散模型,準確度提升的原因
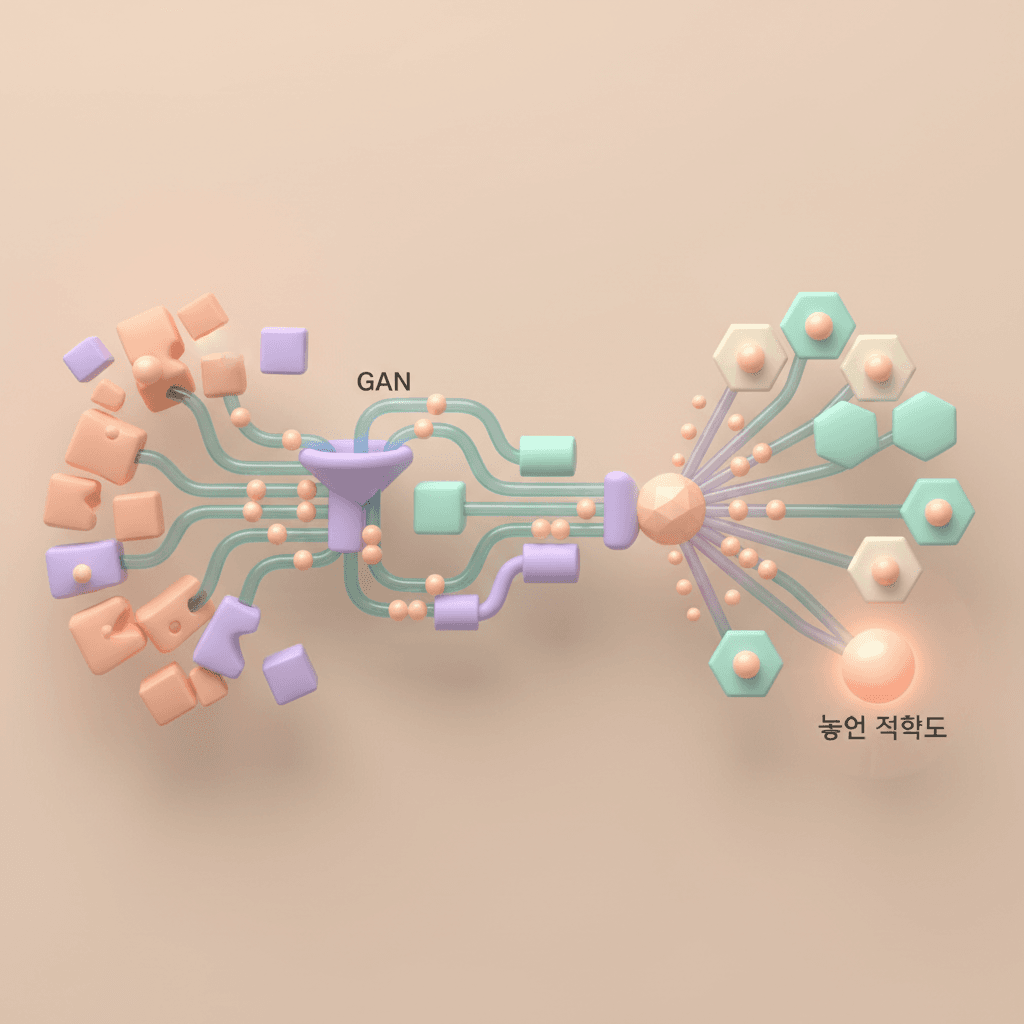
早期的生成式 AI 採用 GAN (Generative Adversarial Network) 方法。
這種方法透過兩個神經網絡相互競爭來生成圖像,但如果學習數據不足,結果就會不穩定。2022 年之前的服務大多屬於此類。
擴散模型則是一種從噪點開始,逐步恢復圖像的結構。它對學習數據的依賴性較低,並且能夠重現細緻的皮膚紋理和陰影。
根據 2023 年史丹佛研究團隊的報告,與 GAN 相比,主觀滿意度提高了 41%(Stanford HAI, 2023)。
重點 擴散模型的關鍵在於「去噪過程」。就像將模糊的照片還原清晰一樣,它從隨機像素開始,逐步找出臉部特徵。
尚未解決的問題:照明、角度、個體差異
問題在於結果會因輸入條件而異。即使是同一張臉,當照明色溫從 3000K 變為 5500K 時,鼻樑高度的判斷差異高達 1.2 毫米。
分別輸入正面照片和 30 度側臉照片,下顎線的預測結果會有所不同。
AI 會根據學習數據的平均值給出答案。對於臉部不對稱嚴重或骨骼結構特殊的人,預測準確度會下降。
結果僅是手術計畫的「起點」,而非最終藍圖。
- 僅照明和角度變數,結果差異高達 30%
- 專科醫生判斷與 AI 預測的一致率為 68-74%
渲染 vs 生成式 AI,技術比較
3D 渲染 (2019 年前) [座標移動]
- 處理時間平均 8 秒
- 僅輸出單一角度
- 無法改變表情
- 無需學習數據
速度快,但結果不自然且受限
擴散模型 (2023 年後) [像素生成]
- 處理時間平均 2.3 秒
- 可生成多角度、表情
- 可重現皮膚紋理
- 需要數千張學習數據
自然,但結果可能因輸入條件而異
AI 模擬,請勿這樣使用
- 請勿將結果作為手術確定的依據 — 這只是預測,並非保證
- 請勿僅憑一張照片做判斷 — 照明和角度改變,結果也會跟著改變
- 請勿在未確認照片儲存和刪除政策的情況下上傳
常見問題
AI 模擬結果與實際手術結果的吻合度有多高?
與專科醫生判斷的一致率為 68-74%,根據照明、角度和個人骨骼特徵,差異最高可達 30%。
上傳的臉部照片儲存在哪裡?
這取決於各項服務,請務必確認個人資訊處理政策。有些服務在分析後會立即刪除,但有些則會將其作為學習數據保存。
GAN 方法和擴散模型,哪個更準確?
擴散模型在皮膚紋理和陰影重現方面具有優勢,根據 2023 年的研究,其主觀滿意度比 GAN 高出 41%。
參考資料
- Diffusion Models in Medical Imaging: A Comparative Study — Stanford HAI, 2023
Lumi 的話
AI 模擬不是鏡子,而是指南針。它能告訴你方向,但最終目的地需要與專科醫生一起決定。如果你對結果有疑問,帶著這些疑問去諮詢吧。這才是最善用這個工具的方法。
本內容僅供參考,不能替代醫療建議。手術前請務必諮詢專科醫生。