IA de simulação, o ponto de viragem tecnológica que definirá o rápido crescimento em 2024
- O motivo do aumento de 73% na adoção de modelos de difusão em 2023
- A renderização 3D mostrava apenas um ângulo, mas a IA generativa cria até expressões faciais
- Ainda é uma limitação que o mesmo rosto produza resultados diferentes quando as condições de iluminação mudam
Informações a partir de novembro de 2026
Da renderização à IA generativa
- Renderização 3D em 2019 → Transição para modelo de difusão em 2023
- Tempo de processamento reduzido de uma média de 8 segundos para 2,3 segundos
- Variação de resultados de até 30% dependendo das variáveis de iluminação e ângulo
3 segundos na tela, meu rosto após o carregamento
Fiz o upload de uma selfie e levantei um pouco a ponta do nariz com os dedos. Fiquei olhando fixamente para a tela durante os 3 segundos de carregamento.
Quando o resultado apareceu, dei zoom na tela sem perceber. Era tão natural que me perguntei se aquele era mesmo o meu rosto.
Mais de 30% das clínicas de cirurgia plástica e dermatologia do país adotaram a simulação por IA em consultas em 2024. Em 2021, eram 5%. O que mudou em três anos?
Renderização em 2019 vs. IA Generativa em 2023, uma bifurcação tecnológica
O método utilizado até 2019 era a renderização 3D. É uma estrutura que lê o rosto em uma grade e move as coordenadas do nariz e do queixo. O processamento era rápido, mas mostrava apenas um ângulo e a expressão facial ficava congelada.
A IA generativa baseada em modelos de difusão (Diffusion Model) se popularizou a partir de 2023. Ela aprende com milhares de imagens de antes e depois de procedimentos para gerar novos rostos.
O tempo de processamento foi reduzido para uma média de 2,3 segundos, e ela cria expressões sorridentes e vistas laterais.
Quiz OX
A simulação por IA baseada em modelo de difusão leva mais tempo para processar do que a renderização 3D
Verificar resposta
X O modelo de difusão leva em média 2,3 segundos, mais de 3 vezes mais rápido que a renderização 3D (média de 8 segundos). Isso ocorre porque a estrutura de geração de pixels é mais eficiente do que o cálculo de coordenadas.
De GAN para Difusão, o motivo do aumento da precisão
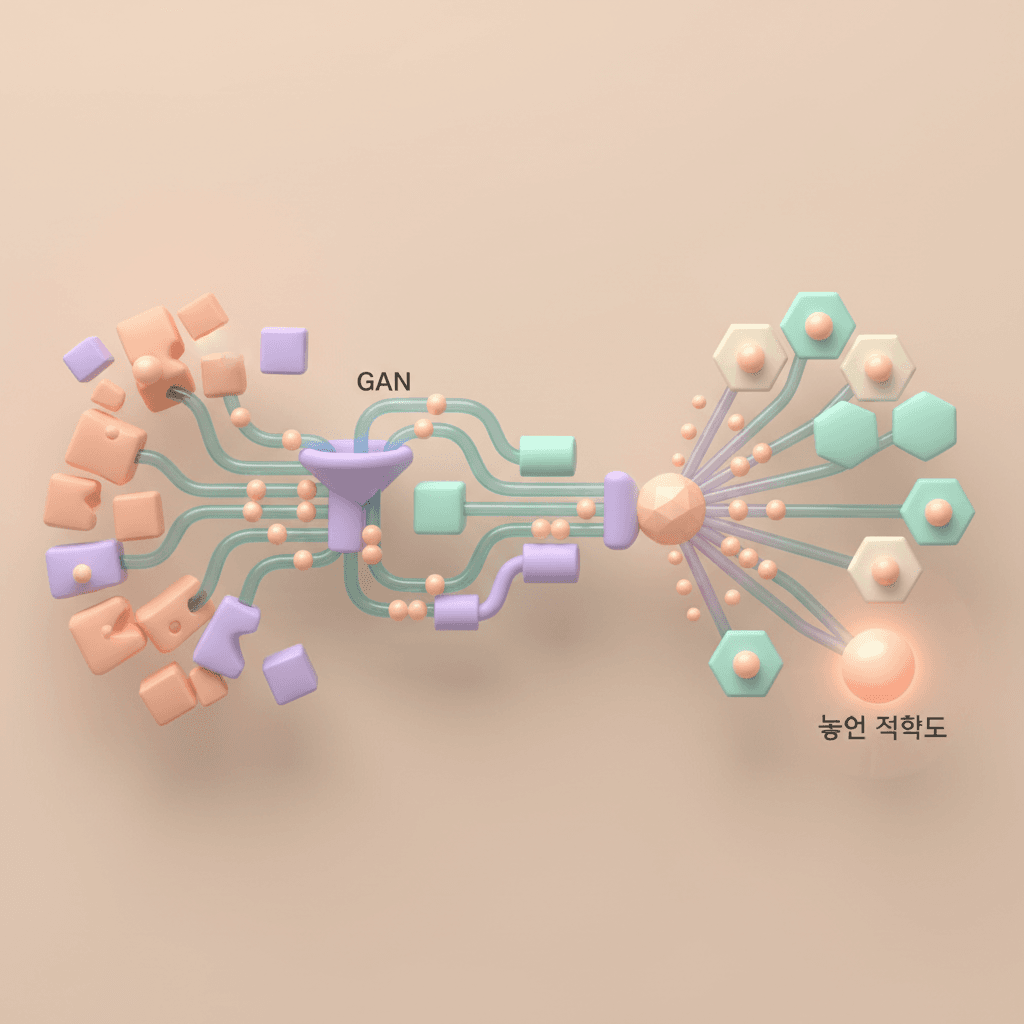
A IA generativa inicial era baseada no método GAN (Generative Adversarial Network).
Duas redes neurais competem para criar imagens, mas os resultados ficavam instáveis com poucos dados de treinamento. A maioria dos serviços anteriores a 2022 se enquadrava aqui.
O modelo de difusão tem uma estrutura que parte do ruído e restaura gradualmente a imagem. A dependência de dados de treinamento é baixa e reproduz até mesmo texturas de pele e sombras detalhadas.
Um relatório de 2023 da equipe de pesquisa de Stanford mostrou que a satisfação subjetiva foi 41% maior em comparação com GAN (Stanford HAI, 2023).
Essencial O processo de 'remoção de ruído' é o cerne do modelo de difusão. Assim como restaurar uma foto borrada para torná-la nítida, ele parte de pixels aleatórios e identifica gradualmente as características faciais.
Ainda não resolvido: iluminação, ângulo, diferenças individuais
O problema é que os resultados variam dependendo das condições de entrada. Mesmo no mesmo rosto, a mudança na temperatura de cor da iluminação de 3000K para 5500K pode causar uma diferença de até 1,2 mm na determinação da altura do nariz.
Inserir uma foto frontal e uma foto lateral de 30 graus resulta em previsões diferentes da linha do maxilar.
A IA responde de acordo com a média dos dados de treinamento. A precisão da previsão diminui em casos de assimetria severa ou estruturas ósseas incomuns.
O resultado é um 'ponto de partida' para o plano de tratamento, não o projeto final.
- Variação de resultados de até 30% apenas com variáveis de iluminação e ângulo
- Taxa de concordância entre o julgamento do especialista e a previsão da IA é de 68-74%
Renderização vs. IA Generativa, comparação de tecnologia
Renderização 3D (antes de 2019) [Movimento de Coordenadas]
- Tempo de processamento médio de 8 segundos
- Saída de apenas 1 ângulo
- Sem variação de expressão facial
- Não requer dados de treinamento
Rápido, mas com resultados artificiais e limitados
Modelo de Difusão (após 2023) [Geração de Pixels]
- Tempo de processamento médio de 2,3 segundos
- Capaz de gerar múltiplos ângulos e expressões
- Reprodução de textura da pele
- Requer milhares de dados de treinamento
Natural, mas com variação dependendo das condições de entrada
Simulação por IA, não use assim
- Não use os resultados como base para confirmar um procedimento — é apenas uma previsão, não uma garantia
- Não julgue com base em uma única foto — os resultados mudam com a iluminação e o ângulo
- Não faça upload sem verificar a política de armazenamento e exclusão de fotos faciais
Perguntas Frequentes
Qual a correspondência entre os resultados da simulação por IA e os resultados reais do procedimento?
A taxa de concordância com o julgamento do especialista é de 68-74%, e a variação pode chegar a 30% dependendo da iluminação, ângulo e características ósseas individuais.
Onde são armazenadas as fotos faciais que faço upload?
Varia de acordo com o serviço, portanto, certifique-se de verificar a política de privacidade. Alguns excluem imediatamente após a análise, mas outros os armazenam como dados de treinamento.
Qual é mais preciso, o método GAN ou o modelo de difusão?
O modelo de difusão tem superioridade na reprodução de texturas de pele e sombras, e estudos de 2023 mostraram 41% mais satisfação subjetiva em comparação com GAN.
Referências
- Diffusion Models in Medical Imaging: A Comparative Study — Stanford HAI, 2023
Nota de Lumi
A simulação por IA não é um espelho, mas uma bússola. Ela indica a direção, mas o destino final é decidido com o especialista. Se você tiver dúvidas após ver o resultado, leve-as para a sala de consulta. Essa é a melhor maneira de usar essa ferramenta.
Este conteúdo tem fins informativos e não substitui aconselhamento médico. Consulte sempre um especialista antes de realizar um procedimento.