AI 评价回顾 2024年 vs 2021年,4个不同标准
- 2021年无法辨别的“以假乱真”,现在该如何识别?
- GPT问世后,评论辨别技术从关键词匹配转向了语境·模式分析
- 但特定条件下仍会出现误判——照片·日期·医院交叉验证是必须的
截至 2026 年 11 月的信息
GPT 之后发生了什么变化
- 引入 Transformer 模型后,上下文判断准确率提升 32 个百分点
- 2021 年以关键词为中心 → 2024 年分析写作模式
- 针对医疗评价的专业学习数据自 2023 年起全面构建
2021 年只抓“生硬表达”
截至 2024 年 5 月,国内 3 家主要医疗平台已引入 基于 GPT 的评价判别。与 2021 年相比,最大的区别在于一点。
那就是 不看单词,而是看整个句子的流畅度。
过去的方式是计算“强烈推荐”、“太棒了”、“完全”等夸张关键词的频率。问题是,真正满意的人也会使用这些词。
2022 年一项美容平台分析显示,基于关键词的判别误报率为 41%。
Transformer 模型带来的改变
2023 年后引入的基于 Transformer 的模型(GPT·BERT 系列)学习句子中单词的连接方式。
“价格便宜效果好”和“效果好但价格便宜”是相同的单词,但强调的重点不同。AI 能读懂这种差异。
另一个是写作模式分析。在同一时间段发布的评价,如果句子结构也相似,就会被视为可疑信号。
截至 2024 年,主要平台的模式检测准确率报告为 78%~84%。
OX 问答
基于 GPT 的 AI 会将使用相同单词的评价全部判别为虚假
确认答案
X Transformer 模型看的不是单词本身,而是句子中单词的排列和强调的流程。即使是相同的单词,如果上下文自然,也可能被判定为真实。
仍然无法捕捉的 3 种情况
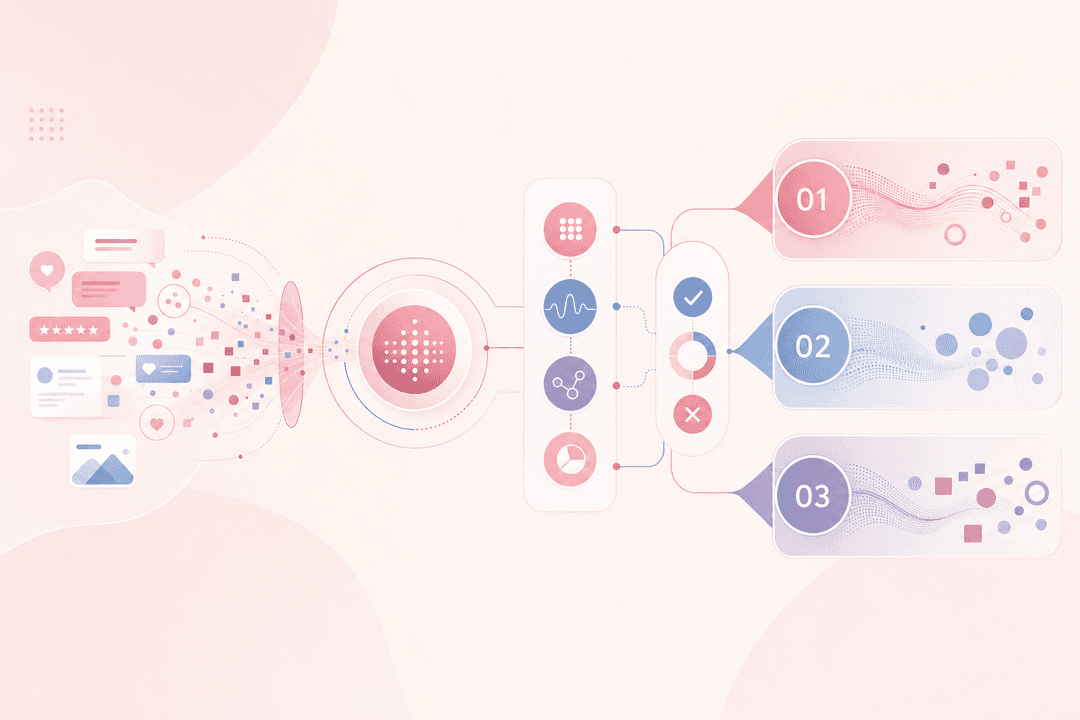
照片和文字脱节的情况仍然是弱点。即使评价文本写得像真的一样,但如果附带的照片是其他医院拍摄的,AI 也无法追踪照片的来源。
这就是需要交叉验证的原因。
时间差操作也是如此。间隔一个月分开上传的评价不会被模式检测到。
此外,还存在医疗专业学习数据不足的问题。通用模型对美容·整形术语的上下文学习不如普通购物评价那样准确。
注意 即使 AI 判别结果显示为“真实”,也需要养成亲自确认照片·日期·发帖人记录的习惯。算法是辅助工具,而非最终判断。
最终还是需要与“人工审核”结合使用
平台采取的方式是为 AI 判别结果配备人工审核员。AI 先初步筛选出可疑评价,然后由人工综合判断照片·医院信息·发帖记录。
截至 2024 年上半年,这种混合方式的准确率提高到 91%~94%。
作为读者,应该关注评价的一致性,而非数量。
即使同一家医院有 100 条评价,如果句子模式相似,也应存疑;即使只有 30 条,如果照片角度·光线·内容各不相同,则可信度高。AI 是工具,最终的判断还是在于你。
- AI+人工审核并行时准确率 91%~94%
- 评价一致性比数量更具参考价值
AI 评价判别,这样使用是错误的
- 不要因为 AI 判别为“真实”就跳过确认照片·日期·发帖人记录。算法无法验证照片来源。
- 不要只看评价数量就决定医院。100 条评价如果句子模式也相似,反而可能是可疑信号。
- 不要将 AI 判别结果作为“虚假确定”的证据。存在误报的可能性,可能构成名誉损害。
常见问题
AI 判别准确率 90% 的话,剩下的 10% 是怎么处理的?
由人工审核员进行二次确认,或者由读者亲自交叉验证照片·日期·发帖人记录等附加信息。
发帖时,我的帖子被 AI 误判为虚假的风险是否存在?
如果反复使用夸张表达或复制粘贴特定短语,可能会被模式检测到。自然地写作并上传自己拍摄的照片即可。
我能确认我发布的评价照片保存在哪里吗?
请在平台的个人信息处理方针中查看图像的保管期限和删除程序。提前确认是否可以根据要求删除比较安全。
参考资料
- Attention Is All You Need — Google Research (Vaswani et al.), 2017
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding — Google AI Language, 2018
Lumi 的一句话
AI 是用于过滤可疑评价的初级过滤器。但是,照片来源·发帖间隔·医院信息是否一致等,还需要亲自用眼睛确认。不要被数字迷惑,要看一致性。如果有想了解的技术,随时欢迎再来。
本内容仅供信息参考,不能替代医疗建议。就诊前请务必咨询专业医生。