AI đánh giá review: 2024 so với 2021, 4 tiêu chí đã thay đổi
- Làm sao để phân biệt 'hàng giả được viết như thật' mà chúng ta không thể nhận ra vào năm 2021?
- Sau sự xuất hiện của GPT, công nghệ phân biệt đánh giá đã chuyển từ khớp từ khóa sang phân tích ngữ cảnh và mẫu.
- Tuy nhiên, trong một số điều kiện nhất định, vẫn có thể đưa ra phán đoán sai — việc kiểm tra chéo ảnh, ngày tháng và phòng khám là điều cần thiết.
Thông tin tính đến tháng 11 năm 2026
Điều gì đã thay đổi sau GPT
- Độ chính xác trong phán đoán ngữ cảnh tăng 32 điểm phần trăm sau khi áp dụng mô hình Transformer
- Từ tập trung vào từ khóa năm 2021 → Phân tích mẫu viết năm 2024
- Xây dựng dữ liệu học tập chuyên biệt cho đánh giá y tế bắt đầu từ năm 2023
Năm 2021 chỉ "bắt lỗi diễn đạt vụng về"
Tính đến tháng 5 năm 2024, 3 nền tảng y tế lớn tại Hàn Quốc đã áp dụng phân biệt đánh giá dựa trên GPT. So với năm 2021, sự khác biệt lớn nhất là một điểm.
Đó là xem xét luồng của cả câu chứ không phải từng từ.
Phương pháp cũ là đếm tần suất các từ khóa cường điệu như 'rất nên', 'tuyệt vời', 'hoàn toàn'. Vấn đề là những người thực sự hài lòng cũng dùng những từ này.
Trong một phân tích của một nền tảng làm đẹp năm 2022, tỷ lệ phát hiện sai của phương pháp phân biệt dựa trên từ khóa là 41%.
Những gì mô hình Transformer đã thay đổi
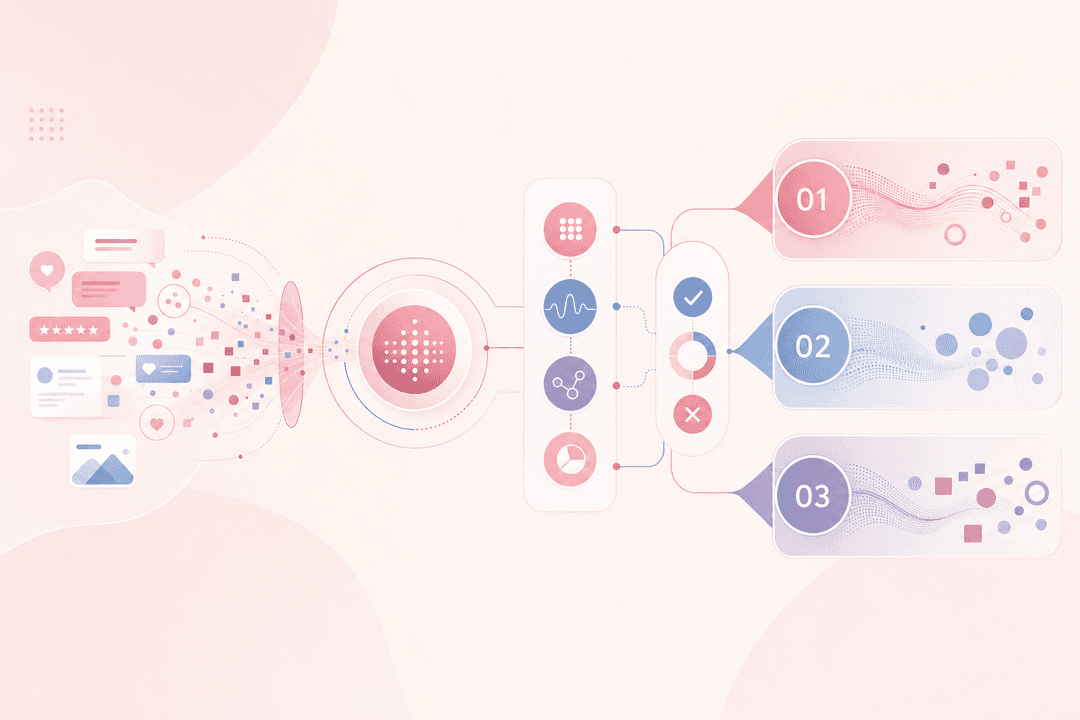
Mô hình dựa trên Transformer (hệ GPT·BERT) được áp dụng từ năm 2023 học cách các từ liên kết với nhau trong một câu.
'Giá rẻ mà hiệu quả tốt' và 'Hiệu quả tốt mà giá rẻ' là cùng một từ, nhưng điểm nhấn khác nhau. AI đọc được sự khác biệt này.
Một điểm nữa là phân tích mẫu viết. Nếu các đánh giá được đăng tải trong cùng một khoảng thời gian có cấu trúc câu tương tự nhau thì đó sẽ bị coi là dấu hiệu đáng ngờ.
Tính đến năm 2024, độ chính xác của việc phát hiện mẫu trên các nền tảng chính được báo cáo trong khoảng 78~84%.
Câu đố OX
AI dựa trên GPT sẽ phân biệt tất cả các đánh giá sử dụng cùng một từ là giả
Xem đáp án
X Mô hình Transformer xem xét cách sắp xếp từ và luồng nhấn mạnh trong câu, chứ không phải bản thân từ. Ngay cả khi dùng cùng một từ, nếu ngữ cảnh tự nhiên thì vẫn có thể được phán đoán là thật.
3 trường hợp vẫn không thể bắt được
Trường hợp ảnh và chữ không khớp vẫn là điểm yếu. Mặc dù văn bản đánh giá có thể viết như thật, nhưng nếu ảnh đính kèm là ảnh chụp từ bệnh viện khác thì AI không thể truy xuất nguồn gốc của ảnh.
Đây là lý do cần kiểm tra chéo.
Thao túng khoảng thời gian cũng vậy. Các đánh giá được chia nhỏ và đăng tải cách nhau một tháng thì sẽ không bị phát hiện bởi việc phân tích mẫu.
Ngoài ra còn có vấn đề thiếu dữ liệu học tập chuyên biệt cho y tế. Mô hình đa dụng chưa học được ngữ cảnh của các thuật ngữ thẩm mỹ·phẫu thuật thẩm mỹ một cách chính xác như các đánh giá mua sắm thông thường.
Lưu ý Ngay cả khi kết quả phân biệt của AI là 'thật', bạn vẫn cần có thói quen kiểm tra trực tiếp ảnh, ngày tháng, lịch sử người viết. Thuật toán chỉ là công cụ hỗ trợ, không phải là phán quyết cuối cùng.
Cuối cùng, cần sử dụng cùng với 'kiểm duyệt của con người'
Các nền tảng đang đi theo hướng bố trí người kiểm duyệt dựa trên kết quả phân biệt của AI. AI sẽ sàng lọc sơ bộ các đánh giá đáng ngờ, sau đó con người sẽ đưa ra phán đoán tổng hợp dựa trên ảnh, thông tin bệnh viện, lịch sử người viết.
Tính đến nửa đầu năm 2024, độ chính xác của phương pháp kết hợp này đã tăng lên 91~94%.
Đối với độc giả, cần xem xét tính nhất quán của đánh giá thay vì số lượng.
Ngay cả khi có 100 đánh giá cho cùng một bệnh viện, nếu mẫu câu tương tự nhau thì cần nghi ngờ, và nếu chỉ có 30 đánh giá nhưng góc chụp ảnh, ánh sáng, nội dung khác nhau thì độ tin cậy cao. AI là công cụ, còn việc phán đoán cuối cùng là của bạn.
- Độ chính xác khi kết hợp kiểm duyệt AI + con người: 91~94%
- Tính nhất quán của đánh giá là chỉ số tin cậy hơn số lượng
Phân biệt đánh giá bằng AI, không nên sử dụng như thế này
- Đừng bỏ qua việc kiểm tra ảnh, ngày tháng, lịch sử người viết chỉ vì AI đã phán định là 'thật'. Thuật toán không thể xác minh nguồn gốc ảnh.
- Đừng quyết định bệnh viện chỉ dựa vào số lượng đánh giá. 100 đánh giá có mẫu câu tương tự nhau thậm chí còn là dấu hiệu đáng ngờ.
- Đừng sử dụng kết quả phân biệt của AI làm bằng chứng 'xác định giả mạo'. Có khả năng phát hiện sai, có thể dẫn đến phỉ báng.
Câu hỏi thường gặp
Nếu độ chính xác phân biệt của AI là 90%, thì 10% còn lại sẽ như thế nào?
Người kiểm duyệt sẽ kiểm tra lần thứ hai, hoặc độc giả cần tự kiểm tra chéo các thông tin bổ sung như ảnh, ngày tháng, lịch sử người viết.
Có nguy cơ AI đánh giá sai bài viết của tôi là giả khi tôi viết đánh giá không?
Nếu bạn lặp lại các biểu đạt cường điệu hoặc sao chép và dán các cụm từ nhất định, bạn có thể bị phát hiện bởi việc phân tích mẫu. Viết một cách tự nhiên và tải lên ảnh tự chụp thì sẽ ổn.
Tôi có thể kiểm tra xem ảnh đánh giá của tôi được lưu trữ ở đâu không?
Hãy kiểm tra thời gian lưu trữ hình ảnh và quy trình xóa trong chính sách bảo mật của nền tảng. Kiểm tra trước xem có thể yêu cầu xóa hay không là an toàn.
Tài liệu tham khảo
- Attention Is All You Need — Google Research (Vaswani et al.), 2017
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding — Google AI Language, 2018
Lời của Lumi
AI là bộ lọc sơ bộ giúp loại bỏ các đánh giá đáng ngờ. Tuy nhiên, bạn cần tự mình kiểm tra nguồn gốc ảnh, khoảng thời gian viết, sự trùng khớp thông tin bệnh viện. Đừng bị lừa bởi con số, hãy nhìn vào tính nhất quán. Nếu bạn có công nghệ nào muốn tìm hiểu thêm, hãy ghé thăm nhé.
Nội dung này chỉ nhằm mục đích cung cấp thông tin và không thay thế cho lời khuyên y tế. Vui lòng tham khảo ý kiến chuyên gia trước khi thực hiện thủ thuật.