AI 評論判斷 2024 年 vs 2021 年,4 項改變的標準
- 2021年無法辨識的「仿冒真品」,現在該如何篩選?
- GPT登場後,評論辨識技術已從關鍵字比對轉向語境・模式分析
- 但特定條件下仍會出現誤判——照片・日期・醫院的交叉驗證是必須的
資訊截至 2026 年 11 月
GPT 之後的變革
- 導入 Transformer 模型後,語境判斷準確度提升 32 個百分點
- 2021 年以關鍵字為中心 → 2024 年分析撰寫模式
- 專為醫療評論打造的學習數據自 2023 年起全面建置
2021 年僅能抓出「生硬的表達」
截至 2024 年 5 月,國內三大主要醫療平台已導入GPT 基礎評論辨識。與 2021 年相比,最大的差異點在於一個地方。
那就是不再只看單字,而是觀察整個句子的語流。
過去的方式是計算「大推」、「超讚」、「完全」等誇飾關鍵字的頻率。問題是,真正滿意的人也會使用這些詞彙。
2022 年一項美容平台分析顯示,以關鍵字為基礎的辨識方法的誤判率高達 41%。
Transformer 模型帶來的改變
2023 年後導入的Transformer 基礎模型(GPT、BERT 系列)能夠學習句子中單字之間的連結方式。
「便宜又效果好」和「效果好又便宜」雖然是相同的單字,但強調的重點不同。AI 能夠讀懂這種差異。
另一項改變是撰寫模式分析。如果在相同時間段發布的評論,其句子結構也十分相似,就會被視為可疑訊號。
根據 2024 年的數據,主要平台的模式偵測準確度報告為78% 至 84%。
OX 測驗
GPT 基礎 AI 會將所有使用相同單字的評論都判斷為假
確認答案
X Transformer 模型觀察的不是單字本身,而是句子中單字的排列和強調的語流。即使是相同的單字,如果語境自然,也可能被判定為真。
仍無法抓出的三種情況
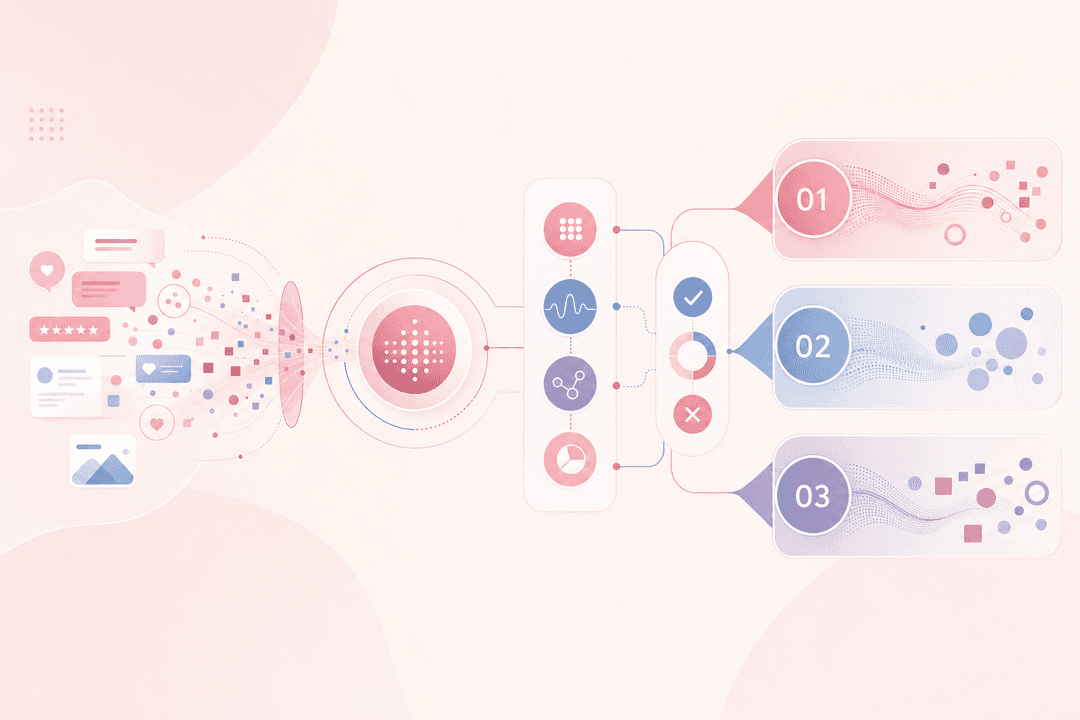
圖片與文字脫節的情況仍然是其弱點。即使評論文字寫得像真的一樣,但如果附上的照片是其他診所拍攝的,AI 無法追蹤到照片的來源。
這也是為何需要交叉驗證的原因。
時間差操作也是如此。間隔一個月才發布的評論,不會被模式偵測到。
此外,還有醫療專用學習數據不足的問題。通用模型對於美容、整形術語的語境學習,不如一般購物評論那樣精確。
注意 即使 AI 辨識結果顯示為「真實」,仍需養成親自確認照片、日期、發文者紀錄的習慣。演算法只是輔助工具,並非最終判斷依據。
最終還是需要「人工審核」
平台們的做法是為 AI 辨識結果配置人工審核員。AI 先初步篩選出可疑評論,再由人工綜合判斷照片、醫院資訊、發文紀錄等。
截至 2024 年上半年,這種混合方式的準確度已提升至91% 至 94%。
對讀者而言,應關注評論的一致性,而非數量。
即使同一家醫院有 100 則評論,如果句子模式相似,就應懷疑;即使只有 30 則,但照片角度、燈光、內容各不相同,則可信度較高。AI 只是工具,最終的判斷還是取決於您。
- AI + 人工審核並行時準確度為 91% 至 94%
- 評論的一致性是比數量更重要的信任指標
AI 評論辨識,這樣做是錯的
- 不要因為 AI 判定為「真實」,就省略確認照片、日期、發文者紀錄。演算法無法驗證照片來源。
- 不要只看評論數量就決定醫院。100 則評論如果句子模式都相似,反而可能是可疑訊號。
- 不要將 AI 辨識結果作為「假評論確定」的證據。誤判的可能性可能涉及名譽損害。
常見問題
AI 辨識準確度為 90%,那剩下的 10% 該如何處理?
由人工審核員進行二次確認,或由讀者自行透過照片、日期、發文者紀錄等附加資訊進行交叉驗證。
撰寫評論時,AI 會不會誤判我的文章為假?
如果重複使用誇飾表達或複製貼上特定文字,可能會被模式偵測到。自然地撰寫並上傳自己拍攝的照片即可。
我可以確認我發布的評論照片儲存在哪裡嗎?
請查閱平台的個人資料處理政策,了解圖片的保存期限和刪除程序。事先確認是否可應要求刪除是比較安全的做法。
參考資料
- Attention Is All You Need — Google Research (Vaswani et al.), 2017
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding — Google AI Language, 2018
Lumi 的話
AI 是用來過濾可疑評論的第一道濾網。但照片來源、發文間隔、醫院資訊是否一致,仍需親眼確認。不要被數字迷惑,要看一致性。若有其他感興趣的技術,歡迎隨時再來。
本內容僅供資訊參考,不能取代醫療建議。進行療程前,請務必諮詢專業醫師。