AI Ulasan 2024 vs 2021, 4 Perubahan Kriteria
- Bagaimana kita membezakan 'palsu yang kelihatan tulen' yang tidak dapat kita tangkap pada tahun 2021 kini?
- Sejak kemunculan GPT, teknologi penapisan ulasan telah beralih daripada padanan kata kunci kepada analisis konteks dan corak.
- Walau bagaimanapun, kesilapan masih berlaku dalam keadaan tertentu — pengesahan silang foto, tarikh dan klinik adalah penting.
Maklumat dikemaskini pada November 2026
Apa yang Berubah Sejak GPT
- Ketepatan penilaian konteks meningkat 32% selepas pengenalan model Transformer
- 2021: Berpusatkan kata kunci → 2024: Analisis corak penulisan
- Data pembelajaran khusus untuk ulasan perubatan mula dibina secara meluas sejak 2023
Pada 2021, Hanya 'Ungkapan Canggung' yang Ditangkap
Sehingga Mei 2024, tiga platform perubatan utama di Korea telah memperkenalkan penilaian ulasan berasaskan GPT. Perbezaan terbesar berbanding 2021 adalah satu.
Ia adalah melihat aliran keseluruhan ayat, bukan perkataan.
Kaedah lama adalah dengan mengira kekerapan kata kunci berlebihan seperti 'sangat disyorkan', 'hebat', 'sepenuhnya'. Masalahnya ialah orang yang benar-benar berpuas hati juga menggunakan perkataan ini.
Dalam analisis platform kecantikan pada 2022, kadar salah pengesanan kaedah penilaian berasaskan kata kunci adalah 41%.
Apa yang Diubah oleh Model Transformer
Model berasaskan Transformer (keluarga GPT·BERT) yang diperkenalkan selepas 2023 mempelajari bagaimana perkataan saling berkaitan dalam ayat.
'Murah tetapi berkesan' dan 'Berkesan tetapi murah' menggunakan perkataan yang sama, tetapi penekanannya berbeza. AI membaca perbezaan ini.
Satu lagi ialah analisis corak penulisan. Jika ulasan yang disiarkan dalam tempoh masa yang sama mempunyai struktur ayat yang serupa, ia dianggap sebagai isyarat kecurigaan.
Setakat 2024, ketepatan pengesanan corak platform utama dilaporkan berada dalam julat 78-84%.
Kuiz OX
AI berasaskan GPT menilai semua ulasan yang menggunakan perkataan yang sama sebagai palsu
Semak jawapan
X Model Transformer melihat penempatan perkataan dan aliran penekanan dalam ayat, bukan perkataan itu sendiri. Walaupun perkataan yang sama digunakan, ia boleh dinilai sebagai tulen jika konteksnya semula jadi.
3 Kes yang Masih Tidak Dapat Ditangkap
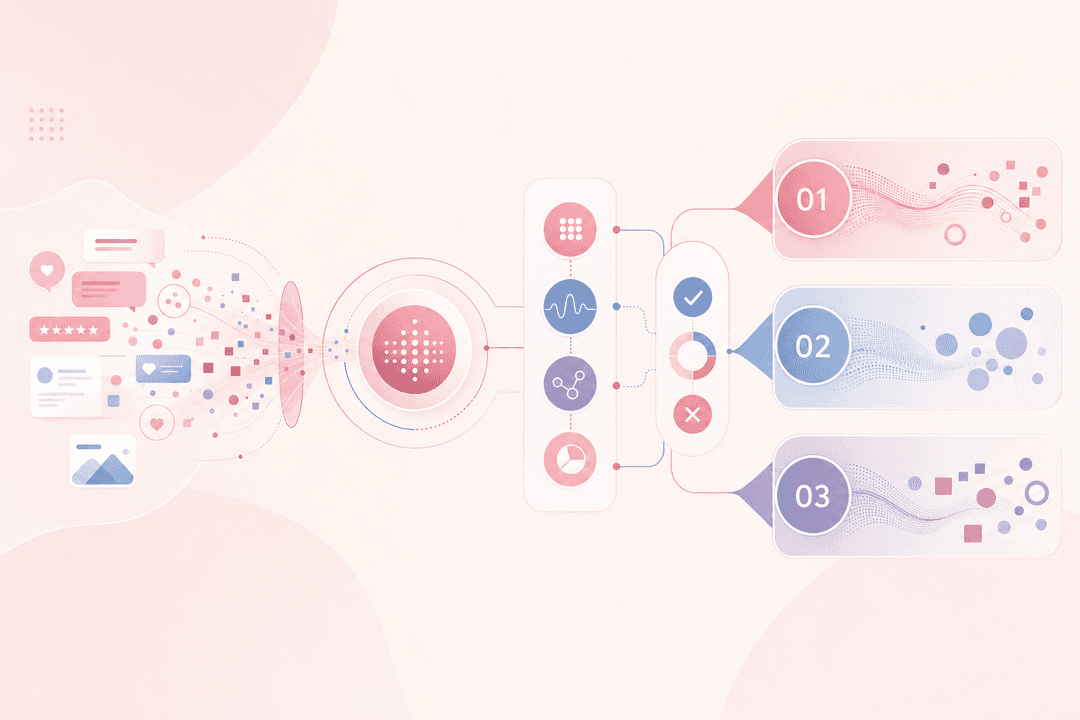
Apabila gambar dan teks tidak sepadan masih menjadi kelemahan. Walaupun teks ulasan ditulis seperti tulen, jika gambar yang dilampirkan adalah daripada hospital lain, AI tidak dapat menjejaki sumber gambar.
Inilah sebabnya mengapa pengesahan silang diperlukan.
Begitu juga dengan manipulasi jurang masa. Ulasan yang disiarkan dengan selang masa satu bulan tidak akan dikesan oleh pengesanan corak.
Terdapat juga masalah kekurangan data pembelajaran khusus perubatan. Model umum tidak mempelajari konteks istilah kecantikan/pembedahan plastik dengan tepat seperti ulasan beli-belah biasa.
Perhatian Walaupun keputusan penilaian AI menunjukkan 'tulen', adalah penting untuk mempunyai tabiat menyemak gambar, tarikh, dan sejarah penulis secara langsung. Algoritma adalah alat bantu, bukan penilaian akhir.
Akhirnya, Ia Perlu Digunakan Bersama 'Pemeriksaan Manusia'
Platform bergerak ke arah menempatkan pemeriksa manusia hasil penilaian AI. AI menyaring ulasan yang mencurigakan terlebih dahulu, dan kemudian manusia membuat penilaian komprehensif berdasarkan gambar, maklumat hospital, dan sejarah penulisan.
Sehingga separuh pertama 2024, ketepatan kaedah hibrid ini meningkat kepada 91-94%.
Dari perspektif pembaca, anda perlu melihat konsistensi berbanding jumlah ulasan.
Walaupun terdapat 100 ulasan untuk hospital yang sama, jika corak ayatnya serupa, ia patut disyaki. Walaupun hanya 30 ulasan, jika sudut gambar, pencahayaan, dan kandungan berbeza-beza, ia mempunyai kredibiliti yang tinggi. AI adalah alat, dan penilaian akhirnya adalah tugas anda.
- Ketepatan 91-94% apabila AI + pemeriksaan manusia digabungkan
- Konsistensi ulasan adalah penunjuk keyakinan yang lebih baik daripada jumlah
Penilaian Ulasan AI, Jangan Gunakan Seperti Ini
- Jangan lepaskan pemeriksaan gambar, tarikh, dan sejarah penulis hanya kerana AI menilainya sebagai 'tulen'. Algoritma tidak dapat mengesahkan sumber gambar.
- Jangan membuat keputusan tentang hospital hanya berdasarkan bilangan ulasan. Jika 100 ulasan mempunyai corak ayat yang serupa, ia sebenarnya adalah isyarat kecurigaan.
- Jangan gunakan hasil penilaian AI sebagai bukti 'pengesahan palsu'. Terdapat potensi fitnah kerana kemungkinan salah pengesanan.
Soalan Lazim
Jika ketepatan penilaian AI ialah 90%, apa yang berlaku kepada 10% yang tinggal?
Pemeriksa manusia akan menyemaknya untuk kali kedua, atau pembaca perlu melakukan pengesahan silang maklumat tambahan seperti gambar, tarikh, dan sejarah penulis.
Adakah risiko AI salah menilai tulisan saya sebagai palsu semasa menulis ulasan?
Jika anda mengulang ungkapan berlebihan atau menyalin dan tampal frasa tertentu, ia mungkin dikesan oleh pengesanan corak. Menulis secara semula jadi dan memuat naik gambar anda sendiri adalah baik.
Bolehkah saya menyemak di mana gambar ulasan saya disimpan?
Semak tempoh penyimpanan imej dan prosedur pemadaman dalam dasar privasi platform. Adalah selamat untuk memeriksa terlebih dahulu sama ada ia boleh dipadam atas permintaan.
Rujukan
- Attention Is All You Need — Google Research (Vaswani et al.), 2017
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding — Google AI Language, 2018
Nota Lumi
AI ialah penapis pertama yang menyaring ulasan yang mencurigakan. Walau bagaimanapun, anda perlu menyemak sendiri sumber gambar, jurang penulisan, dan kesesuaian maklumat hospital. Jangan tertipu oleh nombor; lihat konsistensi. Datang lagi jika anda mempunyai teknologi menarik lain yang ingin anda ketahui.
Kandungan ini adalah untuk tujuan maklumat sahaja dan tidak menggantikan nasihat perubatan. Sila rujuk pakar perubatan sebelum menjalani prosedur.