AI Simulation: จุดเปลี่ยนทางเทคโนโลยีที่จะทำให้ปี 2024 ก้าวกระโดด
- เหตุผลที่อัตราการนำโมเดล Diffusion มาใช้เพิ่มขึ้น 73% ในปี 2023
- การเรนเดอร์ 3 มิติแสดงได้เพียงมุมมองเดียว แต่ Generative AI สามารถสร้างการแสดงออกทางสีหน้าได้
- ข้อจำกัดที่ยังคงอยู่คือ แม้แต่ใบหน้าเดียวกันก็ให้ผลลัพธ์ที่แตกต่างกันเมื่อสภาพแสงเปลี่ยนไป
ข้อมูล ณ เดือนพฤศจิกายน 2026
จากเรนเดอริ่งสู่ AI สร้างสรรค์
- 3D Rendering ปี 2019 → เปลี่ยนเป็น Diffusion Model ปี 2023
- เวลาประมวลผลเฉลี่ย 8 วินาที → ลดเหลือ 2.3 วินาที
- ความคลาดเคลื่อนของผลลัพธ์สูงสุด 30% ขึ้นอยู่กับตัวแปรแสงและมุม
ใบหน้าของฉันหลังโหลดเสร็จ 3 วินาทีหน้าจอ
ฉันอัปโหลดเซลฟี่และใช้นิ้วยกสันจมูกขึ้นเล็กน้อย ระหว่างที่รอโหลด 3 วินาที ฉันจ้องหน้าจอไม่กระพริบตา
เมื่อผลลัพธ์ปรากฏขึ้น ฉันก็ซูมหน้าจอโดยไม่รู้ตัว มันดูเป็นธรรมชาติมากจนฉันอดสงสัยไม่ได้ว่านี่คือหน้าฉันจริงหรือเปล่า
ปัจจุบัน คลินิกศัลยกรรมตกแต่งและผิวหนังกว่า 30% ในเกาหลีได้นำ AI Simulation มาใช้ในการให้คำปรึกษา เพิ่มขึ้นจาก 5% ในปี 2021 อะไรคือสิ่งที่เปลี่ยนแปลงไปใน 3 ปี?
เรนเดอริ่งปี 2019 vs AI สร้างสรรค์ปี 2023 ทางแยกของเทคโนโลยี
วิธีที่ใช้จนถึงปี 2019 คือ 3D Rendering ซึ่งเป็นการอ่านใบหน้าเป็นตารางและปรับเปลี่ยนตำแหน่งของจมูกและคาง แม้จะประมวลผลได้รวดเร็ว แต่ แสดงได้เพียงมุมเดียวและสีหน้าดูแข็งทื่อ
สิ่งที่แพร่หลายตั้งแต่ปี 2023 คือ Generative AI ที่ใช้ Diffusion Model ซึ่งเรียนรู้จากภาพก่อนและหลังการรักษาหลายพันภาพเพื่อ สร้างใบหน้าใหม่
เวลาประมวลผลลดลงเหลือเฉลี่ย 2.3 วินาที และสามารถสร้างสีหน้ายิ้มหรือมุมมองด้านข้างได้
แบบทดสอบ OX
AI Simulation ที่ใช้ Diffusion Model ใช้เวลาประมวลผลนานกว่า 3D Rendering
ตรวจสอบคำตอบ
X Diffusion Model ใช้เวลาเฉลี่ย 2.3 วินาที ซึ่งเร็วกว่า 3D Rendering (เฉลี่ย 8 วินาที) กว่า 3 เท่า เนื่องจากโครงสร้างการสร้างพิกเซลมีประสิทธิภาพมากกว่าการคำนวณพิกัด
จาก GAN สู่ Diffusion เหตุผลที่ความแม่นยำเพิ่มขึ้น
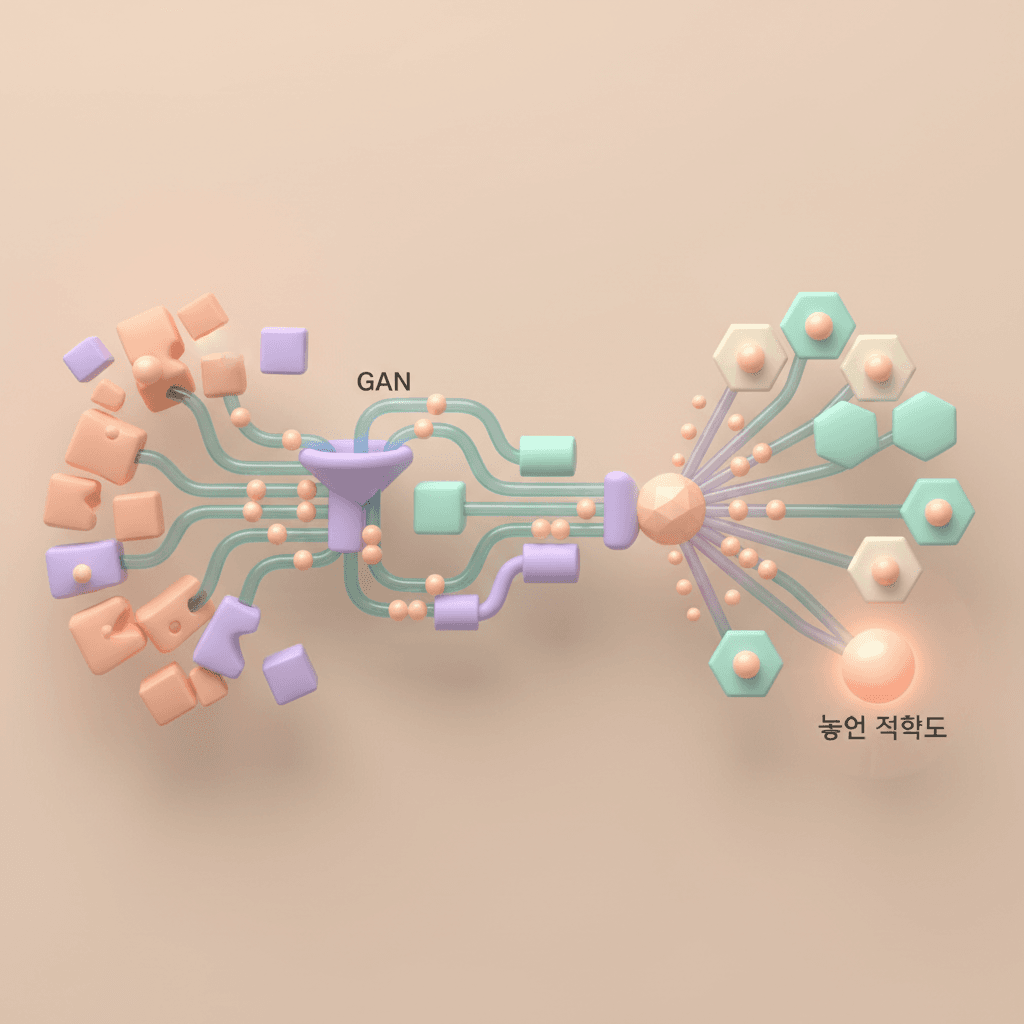
Generative AI ในช่วงแรกใช้เทคนิค GAN (Generative Adversarial Network)
เครือข่ายประสาทเทียมสองเครือข่ายแข่งขันกันเพื่อสร้างภาพ แต่ หากข้อมูลที่เรียนรู้มีน้อย ผลลัพธ์ก็จะสั่นคลอน บริการส่วนใหญ่ก่อนปี 2022 อยู่ในกลุ่มนี้
Diffusion Model มีโครงสร้างที่เริ่มต้นจากสัญญาณรบกวนและค่อยๆ ฟื้นฟูภาพขึ้นมาอย่างต่อเนื่อง ซึ่งพึ่งพาข้อมูลที่เรียนรู้น้อยกว่า และ สามารถสร้างรายละเอียดพื้นผิวผิวหนังและเงาได้อย่างสมจริง
รายงานของทีมวิจัย Stanford ในปี 2023 พบว่าความพึงพอใจเชิงอัตวิสัยสูงกว่า GAN ถึง 41% (Stanford HAI, 2023)
หัวใจสำคัญ กระบวนการ 'กำจัดสัญญาณรบกวน' คือหัวใจสำคัญของ Diffusion Model เปรียบเสมือนการกู้คืนภาพเบลอให้คมชัด โดยเริ่มต้นจากพิกเซลแบบสุ่มและค่อยๆ ค้นหาลักษณะใบหน้าทีละขั้นตอน
สิ่งที่ยังแก้ไขไม่ได้: แสง มุม และความแตกต่างเฉพาะบุคคล
ปัญหาคือ ผลลัพธ์จะแตกต่างกันไปตามเงื่อนไขอินพุต แม้จะเป็นใบหน้าเดียวกัน แต่ เมื่ออุณหภูมิสีของแสงเปลี่ยนจาก 3000K เป็น 5500K การตัดสินความสูงของสันจมูกอาจแตกต่างกันถึง 1.2 มม.
หากใส่ภาพใบหน้าตรงและภาพมุม 30 องศา การคาดการณ์แนวคางจะแตกต่างกัน
AI จะตอบสนองตามค่าเฉลี่ยของข้อมูลที่เรียนรู้ หากมีความไม่สมมาตรอย่างรุนแรงหรือมีโครงสร้างกระดูกที่ผิดปกติ ความแม่นยำในการคาดการณ์จะลดลง
ผลลัพธ์เป็นเพียง 'จุดเริ่มต้น' ของแผนการรักษา ไม่ใช่พิมพ์เขียวสุดท้าย
- ความคลาดเคลื่อนของผลลัพธ์สูงสุด 30% จากตัวแปรแสงและมุมเท่านั้น
- อัตราความสอดคล้องระหว่างการตัดสินใจของผู้เชี่ยวชาญและการคาดการณ์ของ AI อยู่ที่ประมาณ 68-74%
เรนเดอริ่ง vs AI สร้างสรรค์ เปรียบเทียบเทคโนโลยี
3D Rendering (ก่อนปี 2019) [การเคลื่อนย้ายพิกัด]
- เวลาประมวลผลเฉลี่ย 8 วินาที
- แสดงผลเพียง 1 มุม
- ไม่สามารถเปลี่ยนสีหน้าได้
- ไม่จำเป็นต้องใช้ข้อมูลที่เรียนรู้
รวดเร็ว แต่ผลลัพธ์ไม่เป็นธรรมชาติและจำกัด
Diffusion Model (หลังปี 2023) [การสร้างพิกเซล]
- เวลาประมวลผลเฉลี่ย 2.3 วินาที
- สามารถสร้างมุมมองและสีหน้าได้หลากหลาย
- สร้างพื้นผิวผิวหนังได้
- ต้องใช้ข้อมูลที่เรียนรู้หลายพันภาพ
เป็นธรรมชาติ แต่มีความคลาดเคลื่อนขึ้นอยู่กับเงื่อนไขอินพุต
AI Simulation ไม่ควรใช้แบบนี้
- อย่าใช้ผลลัพธ์เป็นหลักฐานในการตัดสินใจรักษา — เป็นเพียงการคาดการณ์ ไม่ใช่การรับประกัน
- อย่าตัดสินจากภาพถ่ายเพียงภาพเดียว — ผลลัพธ์จะเปลี่ยนไปเมื่อแสงและมุมเปลี่ยน
- อย่าอัปโหลดโดยไม่ได้ตรวจสอบนโยบายการจัดเก็บและลบรูปภาพใบหน้า
คำถามที่พบบ่อย
ผลลัพธ์ AI Simulation สอดคล้องกับผลการรักษาจริงแค่ไหน?
อัตราความสอดคล้องกับการตัดสินใจของผู้เชี่ยวชาญอยู่ที่ประมาณ 68-74% และมีความคลาดเคลื่อนสูงสุดถึง 30% ขึ้นอยู่กับแสง มุม และลักษณะโครงสร้างกระดูกเฉพาะบุคคล
รูปภาพใบหน้าที่อัปโหลดจะถูกจัดเก็บไว้ที่ไหน?
แตกต่างกันไปในแต่ละบริการ โปรดตรวจสอบนโยบายความเป็นส่วนตัวเสมอ บางบริการจะลบทันทีหลังการวิเคราะห์ แต่บางแห่งจะเก็บไว้เป็นข้อมูลสำหรับการเรียนรู้
ระหว่าง GAN กับ Diffusion Model แบบไหนแม่นยำกว่ากัน?
Diffusion Model มีความเหนือกว่าในการสร้างพื้นผิวผิวหนังและเงา และจากการศึกษาในปี 2023 ความพึงพอใจเชิงอัตวิสัยสูงกว่า GAN ถึง 41%
แหล่งอ้างอิง
- Diffusion Models in Medical Imaging: A Comparative Study — Stanford HAI, 2023
ข้อคิดจาก Lumi
AI Simulation ไม่ใช่กระจก แต่เป็นเข็มทิศ มันบอกทิศทาง แต่จุดหมายปลายทางสุดท้ายต้องตัดสินใจร่วมกับผู้เชี่ยวชาญ หากคุณมีคำถามหลังจากดูผลลัพธ์แล้ว จงนำคำถามนั้นไปปรึกษาที่ห้องให้คำปรึกษา นั่นคือวิธีที่ดีที่สุดในการใช้เครื่องมือนี้
เนื้อหานี้มีวัตถุประสงค์เพื่อให้ข้อมูลเท่านั้น และไม่สามารถทดแทนคำแนะนำทางการแพทย์ได้ โปรดปรึกษาผู้เชี่ยวชาญก่อนเข้ารับการรักษา